はじめに
 こんにちは。技術本部CTO室、中部支店勤務の中村です。
先日、4/23にオフラインイベント「Sansan Tech Talk @関西 vol.3 〜データ活用のリアル〜」をSansan関西支店にて開催しました。
本記事では、イベントの様子を簡単に振り返ります。
前置き:そもそもSansan Tech Talkとは?
Sansanは現在、地方拠点のエンジニア採用に力を入れており、その一環として各拠点で技術イベントを開催・共催しています。各拠点に所属するメンバーや地域コミュニティーの傾向などを考慮してイベントを設計しており、2026年4月時点では、
- 関西支店では、「Sansan Tech Talk」シリーズ(#kansai_33techtalk)
- 福岡支店では、「Fukuoka_33tech」シリーズ(#fukuoka_33Tech)
- 中部支店では、「Nagoya Tech Talk」シリーズ(#nagoya_tech_talk)
を開催しています。また、シリーズものではありませんが、京都にはSansan Innovation Labという拠点もあり、「ICLR2026 論文読み会」などのアカデミック向けイベントを開催しています。
本編:イベントレポート
本イベントでは、Sansanのエンジニア3名と一般応募枠2名によるデータ活用に関する実践知の共有LT、および懇親会を行いました。
オープニング
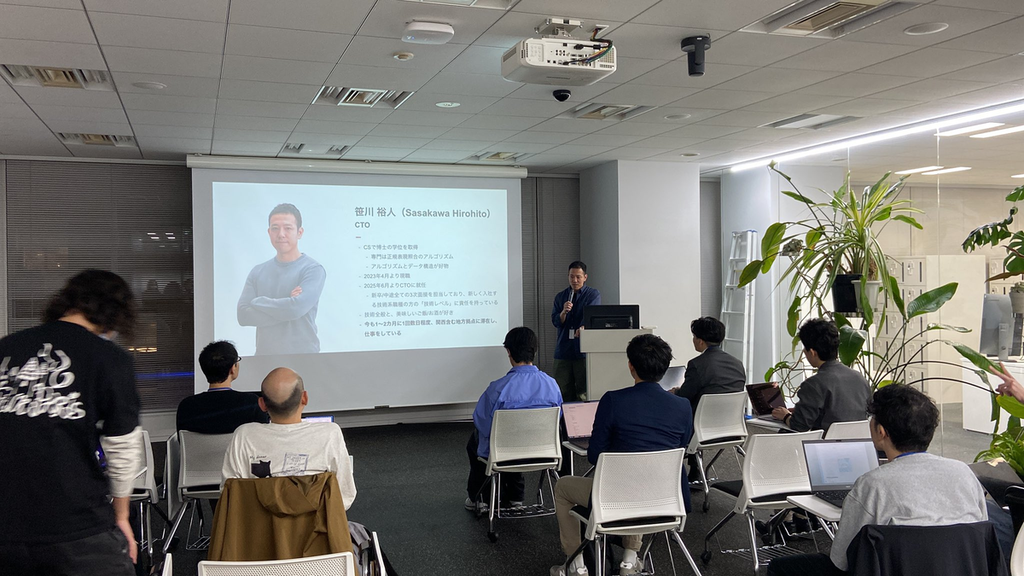 オープニングでは、CTO笹川からSansan関西支店の紹介がありました。関西支店は、大阪駅や西梅田駅、北新地駅などから堂島の地下街を抜けて徒歩5〜10分ほどでアクセス可能です。エンジニアは30名ほどが所属しており、地方拠点の中でも最大規模の支店です。
また、関西支店を含めた地方拠点のエンジニア採用に力を入れている背景や地方拠点勤務のメリットなどの話もありました。詳細が気になった方は、ぜひこちらの記事をご覧ください。 buildersbox.corp-sansan.com
Talk1. 運用システムにおけるデータ活用とPlatform
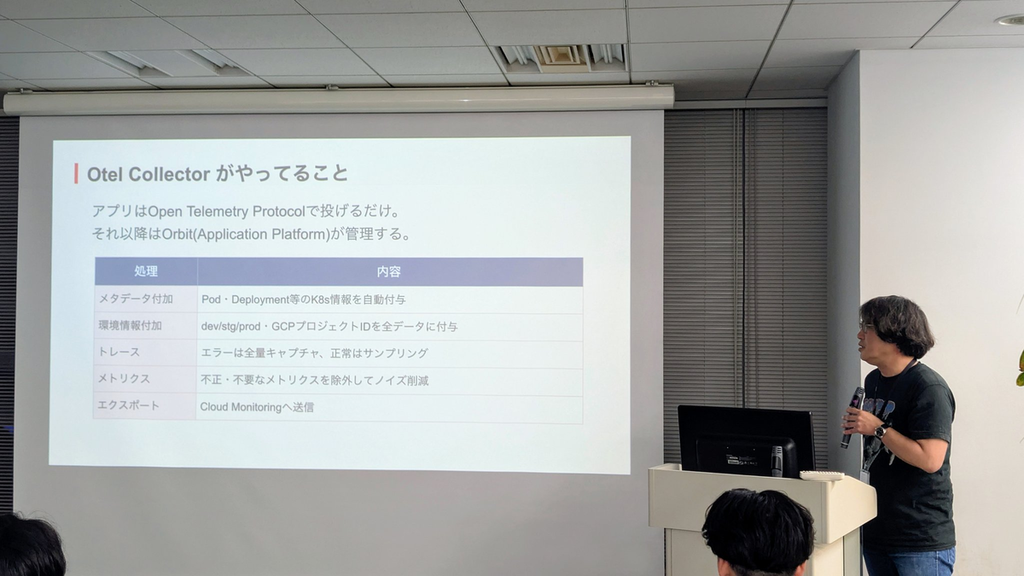
トップバッターはPlatform Engineering Unit所属の水谷から、Platform Engineeringにおけるデータ活用についての発表でした。
インフラやアプリケーションのログ・トレースなどのデータは、活用はおろか収集すらできておらず、障害調査や設定が属人化しやすい——そんな課題はよくありますが、Sansanでも例外ではありませんでした。
そこでPlatform Engineering Unitでは、Orbitというコンテナアプリケーション基盤を開発・提供しました。Orbitを利用することで、アプリケーション開発者は運用データを意識することなく、整備された形で収集できます。また、アラート原因調査においてもGemini Cloud Assist Investigationsを活用し、膨大なテレメトリデータから原因特定の仮説を提示することで、調査の属人化を防ぐ仕組みを提供しているという内容でした。
CTO室でもAIアプリケーションを開発しており、その一部をOrbit上で稼働させていることから恩恵を実感しています。(Orbitについては実録・Platform Engineering 失敗から学び、AI時代の波を乗りこなす技術 - Speaker Deck にて詳しく紹介しています。)
Talk2. これからの「データマネジメント」の話をしよう
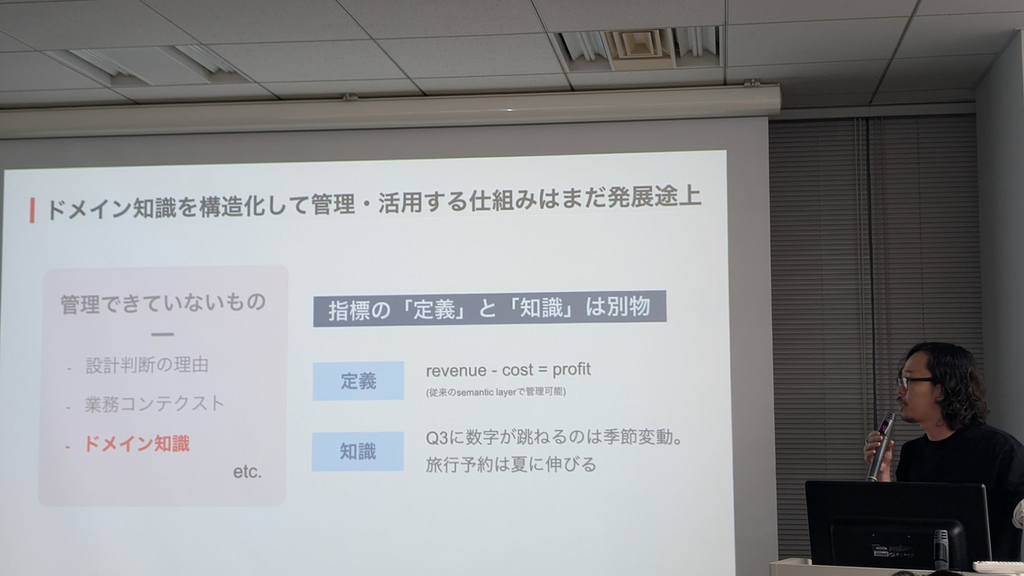
Sansan事業部プロダクト室の坂口からは、AI時代の今、そしてこれからに求められるデータマネジメントについての発表がありました。
データ基盤の技術スタックや手法が進化・確立し、構造化データのマネジメントは成熟しつつある一方、生成AIが普及する中では、構造化データに加えて、外部のドメイン知識や業務コンテキストを構造化したナレッジ基盤を構築することが重要である。そうすることで、AIによるデータ分析の精度向上や、これまで人手で行ってきた構造化データ整備の自動化につながるという内容でした。
また、実際にこの取り組みの検証として進めている、Bill Oneデータ分析エージェントの構成についても紹介されました。
Talk3. Data Enabling Teamのこれから
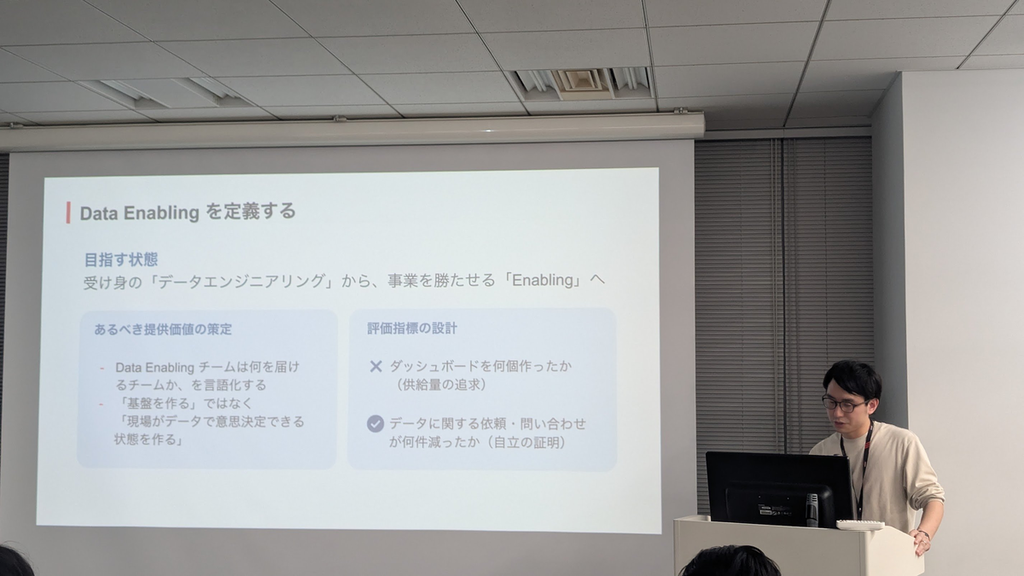
CTO室の矢田は、Data Enabling Teamの立ち上げとこれからの取り組みについて発表しました。
Sansanのデータエンジニア組織は少人数の職人集団で構成されており、データ活用ニーズが高まるにつれ、各事業部から寄せられる分析依頼やダッシュボード作成依頼などがボトルネックになりやすいという課題がありました。 その課題に対処すべく、「データエンジニアはデータ基盤を作りデータを提供する」から「現場がデータで意思決定できる状態を作る」への転換を目指して、Data Enabling Teamを立ち上げました。
そして具体的な取り組みとして、「過去の分析依頼内容を元にした、AIによる一次回答の自動提供」や「法務部・情報セキュリティ部と連携した、データアクセス管理統制の最適化」を進めているという内容でした。
Talk4. AI時代に増えるデータ活用先
LT登壇枠一人目は、STORES 株式会社の小野さん(https://x.com/taaaaaaakayuki) による、全社のデータ利活用促進に向けた取り組みの発表でした。
STORESでは、エンジニア以外の職種の方にもClaude Codeを導入してEnablingを行うことで、データ抽出や分析のハードルを下げているとのことでした。また、データの可視化についても、既存のBIツールを提供するのではなく、フロントエンドとSQLを書けばデプロイできるダッシュボードアプリケーション基盤を提供することで、誰でも手軽にデータを可視化できる仕組みを整えているそうです。
ダッシュボードはコード管理されないことが多く無法地帯になりがちで、その回避策としてBI as Codeのソリューションが選ばれることが多いと思いますが、スクラッチアプリケーションを提供し、誰でもAIコーディングエージェントを用いて開発できるようにするというアプローチは非常に興味深いものでした。
Talk5. データ定義の混乱と戦う 〜管理会計と財務会計〜
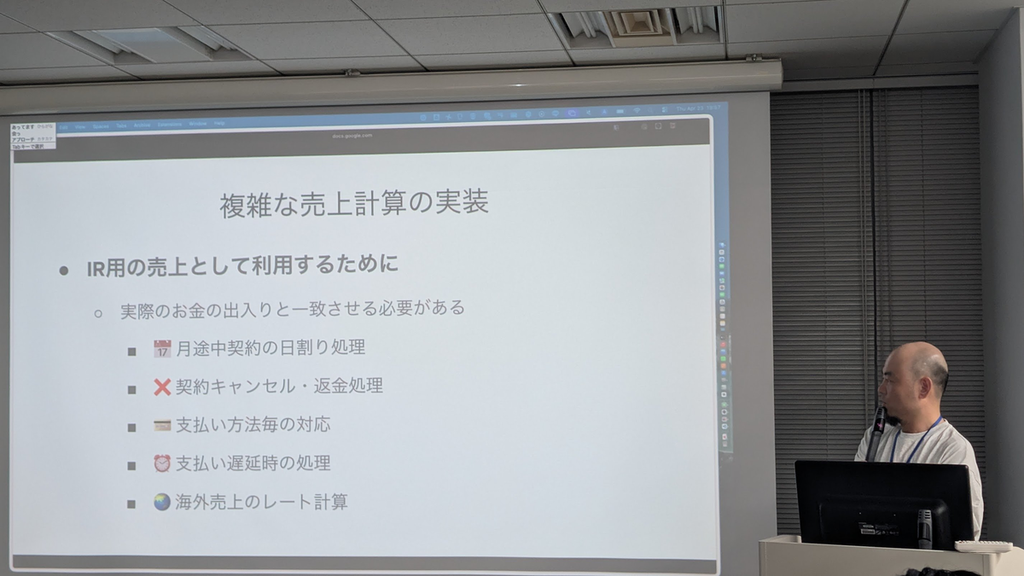
LT登壇枠二人目は、株式会社ヌーラボの尾上さん(https://x.com/wonohe)による、泥臭い会計データに向き合ったという内容の発表でした。
尾上さんが所属する部署では、上場準備のためにIRデータを整備するデータ基盤を構築することになり、数字の正確性が求められたため、複雑な計算ロジックを元に実装されたそうです。
上場後、マーケティングメンバーが意思決定のためにIRデータを参照した際、数字に違和感があるという事態が発生しました。
原因は、IRとマーケで求められるデータ定義が異なっていたことでした。尾上さんは、IRデータ(財務会計)とマーケデータ(管理会計)の定義の違いを明確にして両者を分けることで、データ定義の混乱と戦ったと語られていました。
私も日々、SFAなどの営業・契約データを元にした分析を行っており、定義や解釈の違いに悩まされることが多いので、とても共感できました。
懇親会
トークセッションの後には懇親会も行われました。 さまざまな職種の方が参加されており、登壇内容を深掘りした議論や、各社のデータ活用に関する課題・取り組みについての情報交換が行われていました。私は関西支店でのエンジニアイベントに参加するのは初めてだったのですが、拠点エリアが異なるため普段はお会いする機会のない方々と交流でき、貴重な体験となりました。
おわりに
改めて、ご登壇いただいた皆さま、会場にお越しいただいた参加者の皆さま、本当にありがとうございました。
5/21(木)にも関西支店で次回イベント「Sansan Tech Talk @関西 vol.4 〜データ正規化の深淵〜」を予定しておりますので、ぜひ奮ってご参加ください!!
また、5月には中部支店、Sansan Innovation Lab(京都)でもイベント開催を予定しておりますので、こちらもぜひご参加ください。
Sansan技術本部ではカジュアル面談を実施しています
Sansan技術本部では中途の方向けにカジュアル面談を実施しています。Sansan技術本部での働き方、仕事の魅力について、現役エンジニアの視点からお話しします。「実際に働く人の話を直接聞きたい」「どんな人が働いているのかを事前に知っておきたい」とお考えの方は、ぜひエントリーをご検討ください。
