この記事は、 When Development Got Faster, QA Had to Follow: Building an AI-Assisted Test Execution Toolkit を日本語訳したものです。
はじめに
Sansan Global Development Center, Inc.(SGDC)でQAリードを務めるReubenです。私たちのチームは、経理AXサービス「Bill One」のAI自動照合機能における、QAエンジニアリングの大部分を担当しています。本稿では、手作業で実施していたE2Eテストの所要時間をどのように削減したか、そのために何を構築する必要があったかを紹介します。
課題:実装は高速化したが、検証は追随しなかった
開発チームはAI支援開発を導入し、狙いどおりの成果を得ました。しかし、プルリクエストはAI導入前のベースラインと比べて明確に早く到着するようになったものの、誰も見込んでいなかった問題も生じました。
システムレベルのE2Eテストは、依然としてその大半が手動です。担当領域の機能レベルのリグレッションを1周させるには、人が一覧画面を操作し、ファイルを取り込み、フォームを入力し、非同期ジョブの完了を待ち、画面から結果を読み取る作業が発生します。そのため、コードが早く上がってきても、これらの作業が速くなるわけではなく滞留が生じます。
結果としてデリバリー全体のバランスが崩れました。実装で削減したはずの1時間は、検証ゲートでそのまま帳消しになっていたのです。PBIは「完了」のまま未検証で積み上がり、獲得したはずの速度向上は外部から観測しづらい状態になっていました。
対策として2つのアプローチを検討しました。1つはトレーサビリティとスコープ削減のためのツールで、ある変更に対して実際にテストすべき範囲を判定するものです。これについては別稿で扱います。本稿で述べるのは2つ目、実行そのものの高速化です。
検討した3つの選択肢
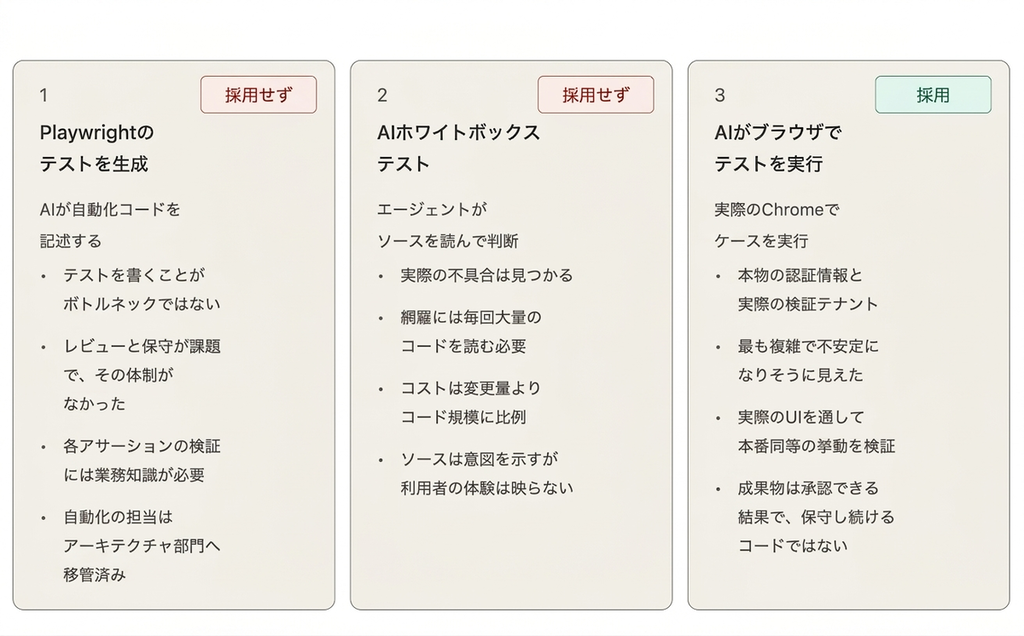
アプローチの要点
ブラウザを操作するLLMは、単体でもアプリケーションを相応に操作できます。単体では行えないことは、作業が完了したか、成功したか、そして今観測した内容が事実かどうかを安定して判断することです。
そのため本ツールキットは、ガードレール、マップ、決定的なスクリプト、ルールの集合として設計しました。有能ではあるが観測を鵜呑みにしがちな実行主体を、再現性のあるテスト実行者に変えるための仕組みです。次に何を行うかはエージェントが判断し、実際に何が起きたかはスクリプトが証明します。
以下に挙げる要素は、大きく分けてエージェントの判断を方向づけるものか、結果を証明するもののどちらかです。
構築の手順
1. 対象範囲を先に確定する
私たちが所管するのはAI自動照合機能であり、マッピング対象もそこに限定しました。1領域をエンドツーエンドで、そのテストケースを実行できる深さまで押さえています。
これは重要な判断でした。全体を浅くマッピングすると、任意のページに到達できるが何も検証できないエージェントが出来上がります。私たちが必要としていたのは、現時点でAI自動照合機能のリグレッションを完走できるものだったため、深さを優先しました。
2. 要素マップを整備する
テストを実行する前に、エージェントが毎ステップでUIを再発見する状態を解消する必要がありました。制御しない場合、エージェントはページのアクセシビリティスナップショット全体を取得し、推論し、クリックし、再度取得します。データ密度の高い一覧画面では、1回のスナップショットが10万文字を超えることもあります。低速かつ高コストであり、しかも再現性がありません。同一のテストが実行ごとに異なる経路を通るためです。
そこで、リポジトリにコミットする要素マップを生成しました。領域内の各画面について、操作対象となるすべての要素の安定したロケーターに加えて、一覧のあらゆる状態(フィルタ、ステータス、検索、ソート、ページ)に対応するディープリンクURLのテンプレートを用意しました。成果物は2種類あります。
- 新規の自動化を記述する際に参照する、人間向けのマップ
- 画面ごとにゲート、安定セレクタ、当該画面の読み取りオラクルとなるAPIエンドポイントおよび更新系エンドポイントを記録した、機械可読のマップ
3. 既知の経路を「フロー」として固定する
フローとは、すでに判明している経路を記述したスクリプトです。ファイルの取り込み、文書のアップロード、照合ジョブの実行、レコードの検証、フィルタした一覧の削除、テナント設定の切り替えなどが該当します。いずれもテスターがすでにログイン済みのブラウザにアタッチし、手順全体を数秒で実行します。
ツールキットの中で最も効果が大きいのはこの部分です。フローは以下の性質を備えます。
- 再現性:同一の入力に対して、常に同一の手順を実行する
- 低コスト:エージェントの数十ターンとスナップショットが、1コマンドに置き換わる
- レビュー可能:バージョン管理下の通常のコードであり、既知の落とし穴も併記されている
- 分類済み:すべてのフローにread-onlyまたはmutatingのタグを付与している。read-onlyは事前承認済みで中断なく実行され、mutatingは設計上必ず承認を求める。この方針は意図的に維持している
エージェントが従う判断順序は、フローが存在すればフロー、なければ要素マップ、そのどちらにも記録がないUIに限って、その場で画面を見ながらの手探りの操作、というものです。の方式によって知見を継続的に蓄積できるのは最後のルールがあるためです。対話的に辿った経路が安定した時点でフローに固定するため、探索は一度限りのコストになります。
効果は明確です。UI経由で1件あたり約18秒を要していた項目更新は、API経由では1件あたり約0.2秒で完了します。50件の文書登録は、1件ずつ実施すると約5分を要しますが、一括実行では36秒で完了しました。
4. 結果の妥当性を担保するルールを明文化する
想定外だったのがこの部分であり、他チームにも最優先で着手するよう勧めたい部分でもあります。
UIを操作するエージェントは、不確かな結果でも確信を持って報告することがあります。成功トーストを観測しただけでテストが通過したと報告し、データが到着する0.5秒前にテーブルが空であったというだけで一覧を0件と報告します。いずれもfalse pass(誤った合格)であり、false passはテストが存在しない状態より問題になり得ます。信頼を損なう可能性があるからです。
したがって、ツールキットの中核となるルールは次の通りです。
UIのシグナルをオラクルとして扱わないこと。描画された行数、成功トースト、スピナーの消失は、タイミングに関する手がかりであって、状態に関する証拠ではありません。結果はAPIと突き合わせて証明します。
これは理論上の話ではありません。2週間のうちに3度、問題が発生したため明文化しました。
| スクリプトの報告 | 実際の状態 | 発生した問題 |
| 「レコードが見つからない」 | 発注データは当初から存在していた | 検証スクリプトがページの読み込みに固定で1.2秒しか割り当てていなかった。低速な環境ではスクリプトの参照時点でテーブルが空であり、空のテーブルは真の0件と区別できない |
| 「空にした」 | 何も削除されていなかった | 同じ固定待機を、今度はクリーンアップスクリプトで使用していた。一覧を開き、空のテーブルを確認し、処理済みと判断して停止した |
| エラーで終了し、レポートも出力されず | 実際には120件中100件が削除済みだった | 同じクリーンアップスクリプトで、その翌日に発生。画面上の「削除しました」表示を証拠として扱っていた。この表示は一時的なもので、スクリプトが参照する前に消えることも、低速な環境ではスクリプトが待機を打ち切った後に表示されることもある |
3件のうち2件は同一の誤り、すなわち画面の読み込み完了を前提としたことに起因します。また2件は同一スクリプトで、1日おいて発生しました。
修正の方向はいずれも同じでした。待機処理は、所要時間を推定してスリープするのではなく、データの到着をポーリングします。そして実際に取得できた行数を報告します。0件は「一覧が空である」ではなく「時間内にデータが到着しなかった」を意味するため、空の一覧を前提に動作する処理は、必ず先にAPIで確認します。画面上のメッセージは引き続き記録しますが、あくまで手がかりとしての扱いです。削除を証明する際は、クリーンアップスクリプトがサーバー側の件数を参照し、削除した行数と一致する減少が生じたことを確認します。
このルールには、対となる重要な規定があります。前半のみが逆の意味で解釈されやすいためです。「APIがオラクルである」とは検証の方法を定めたものであり、不一致の迂回を認めるものではありません。
APIと矛盾するUI、ダウンロード、エクスポートは、それ自体が不具合です。
対象となるのは、例えば金額が突合しない、書き込みが成功を返しながら永続化されていない、同一クエリでページャーの表示がAPIと食い違う、エクスポートの値が画面表示と異なる、といった事象です。これらはそれぞれ独立した発見事項であり、固有の深刻な課題を持ちます。全ステップが通過することで、さらなる発見事項は発生する場合があり、実行結果が緑であることがそれを打ち消すことはありません。あわせて運用しているルールとして、まず非同期の遅延を排除します。両方の面を文書化されている想定遅延時間が過ぎてから、UIとAPIの両方を2回読み取り、双方のタイムスタンプを記録することで、誤検知を防ぎます。真の発見事項であれば、処理を停止し、証拠を保全し、クリーンアップは実施しません。
対応する安全規定も整備しています。更新系スクリプトは、接続先がステージング環境またはローカル環境でない場合、更新系スクリプトは自動的に処理を中断します。破壊的な操作は事前にスコープを確定し、対象集合まで正確にフィルタした上で件数とサンプルを報告し、確認ダイアログが提示する件数を読み返してから確定します。エージェントは本番環境に一切アクセスせず、ログイン操作も扱いません。
5. テストデータの課題を解決する。これをなくして他の施策は成立しない
この点の見積もりは完全に誤っていました。当該領域のE2Eテストケースは、その大半が現時点で存在しない事前条件を必要とします。特定の状態にある文書と、照合ルールを満たすフィールドを備えたレコードの組み合わせです。このルールは非常に細かく、かつ大部分が文書化されていません。1つでもフィールドを誤ると、テスト対象の機能は何も動作せず、その挙動はバグと酷似します。
そこで、テストデータをツールキットの中核要素として位置付けました。
- シナリオを解するジェネレーター:テストケースが必要とする成果物、すなわち文書と取り込みファイルを、特定のシナリオを成立させる形で生成します。シードを固定し、出力を容易に再現できるようにしています。
- 実スキーマの利用:取り込みファイルのレイアウトは対象テナントの設定に依存するため、生成時に当該テナントのテンプレートを取得します。
- プロビジョニングエージェント:データ仕様を受け取り、一連の処理を実行します。テナントの既存データを調査し、不足分のみを計画し、生成し、アップロードし、シナリオが成立するよう双方のフィールドを整合させ、APIによる一括確認を経て、作成した識別子を返却します。
- 明示的に定義する必要があった区別:「成立する候補が存在することを保証する」とは、先に調査した上で不足分のみを作成することです。「生成して取り込む」は、既存レコードでは件数を満たせないため、新規データを作成することを意味します。両者はほぼ同義に読めますが、要求される動作は正反対です。これを取り違えた結果、既存データの再生成や不要な調査が発生し、実行ごとに数分を失いました。
ジェネレーターの開発を通じて判明した製品側のデータ制約は、すべてランブックとして文書化しました。現在では、実行中に最も参照される資料の1つとなっています。
6. 実行し、失敗し、すべての失敗を知識に変換する
初期の実行には相応の介入が必要でしたが、これは想定内です。仕組みとして機能させられた要因は、失敗の扱いに規律を設けたことにあります。
すべての失敗を、記述された成果物、すなわち文書化された挙動として残しました。現在、gotchas(既知の落とし穴)の文書には数十件が蓄積されています。値の直接代入を無視する制御付き入力、ネイティブのダイアログハンドラから認識されないDOM内ダイアログ、クライアントサイドキャッシュ経由の遷移後に描画されるテーブル、一時キャッシュにすぎない結果URL、一覧より数秒遅れて実行される非同期の再計算などです。
いずれも推論によって発見できるものではなく、かつ支援のないエージェントにとっては致命的です。しかし、一度文書化すれば、再発見の必要はありません。
ルール、マップ、フロー、ジェネレーター、gotchasを合わせたものが、エージェントの運用マニュアルです。これらはプロジェクト指示およびスキルとして読み込まれるため、誰かが明示的に指示しなくても知識が適用されます。
7. プリフライトを設け、乖離を確実に検知する
要素マップは、開発が継続中のUIのスナップショットにすぎません。UIが変更されマップが追随していない場合でも、実行結果は緑のまま通過します。ただし、その結果は意味を失います。これは想定される中で最も望ましくない失敗です。
そのため、各セッションの冒頭で読み取り専用のチェックを2つ実行します。ブラウザに到達可能でログイン済みであるか。そして、これから操作する領域について、要素マップが実DOMと一致しているか。1領域に限定すれば数秒で完了します。失敗した場合は処理を中止し、何も実行していない状態にマップを修正します。プリフライトが失敗した状態で押し通すことは、もっともらしく見えるが何も証明していないレポートを生成する行為にほかなりません。
現在の実行サイクル
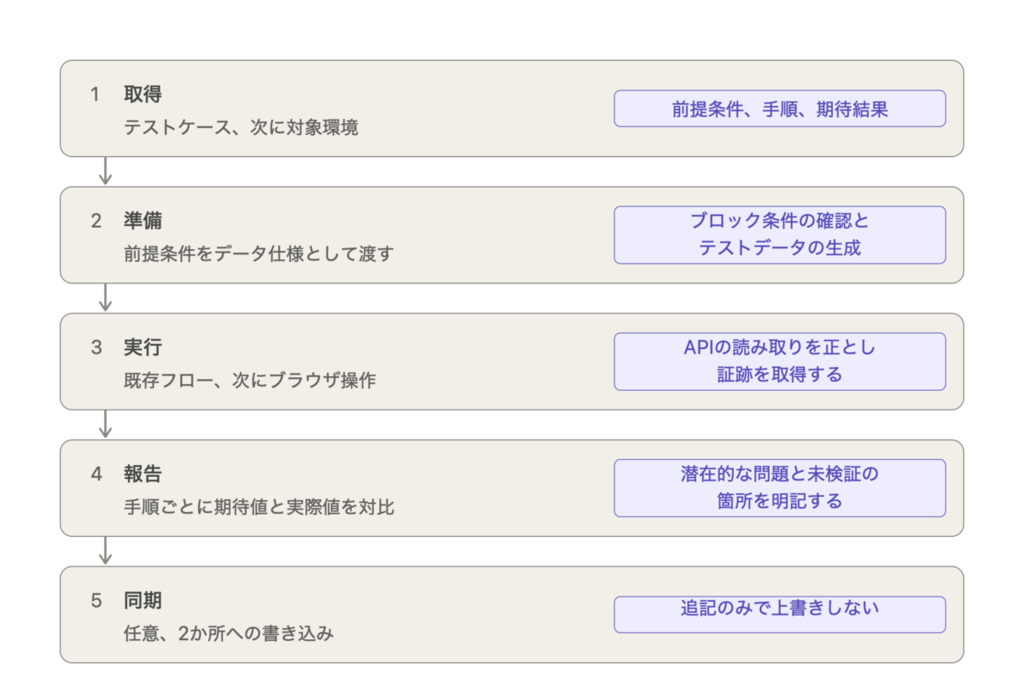
現時点の実測値
実行工数はPBIあたりのQA実行日数で測定しています。比較対象は、本施策の着手前に記録した手動のベースライン、すなわち小規模PBIで3日、大規模PBIで6日です。1四半期を経過し、ワークロードの一部にツールキットを適用した時点の結果は以下の通りです。
- 小規模PBIは平均1.5実行日。ベースライン3.0日に対し、目標として設定した50%削減を達成
- ツールキットを適用した最初の大規模PBIは3.0実行日。ベースライン6.0日に対して同じく50%の削減で、73ケースの実行を伴うもの
- ツールキット未適用の実行を含む3件の大規模PBIの平均は4.33実行日、削減率27.8%。このサイズでは目標未達
- 総合すると、50%削減目標に対する達成度は78%です。この数値は、各サイズが目標をどの程度達成したかの平均であり、小規模は目標の100%(50%目標に対し50%削減)、大規模は56%(同目標に対し27.8%)に相当します
3件の大規模PBIのうち1件は、実行自体は短時間で完了した一方、その実行で複数の問題が検出され、リリース前にトリアージおよびクローズを行いました。その検証と再テストに要した実行日数は、上記の削減率には反映されていません。実行が高速化すれば問題が検出される機会も増える可能性があり、検出された問題は別の工程でコストを生じます。
得られた知見
ブラウザ操作モデルの性能は、私たちの用途においてはすでに十分です。 投入した時間のほぼすべては、地味な基盤整備に費やされました。マップ、決定的なスクリプト、オラクル、データジェネレーター、文書化された挙動です。高速な実行を期待する前に、この整備に1四半期を見込んでください。特にUIの挙動が変動し続けている場合はなおさらです。
最大のリスクはfalse passです。 ツールキット内の一見過剰に見えるルールは、いずれも、確信度の高いエージェントが実態と異なる緑の結果を報告したことに起因します。フローを設計する前に、オラクルを設計してください。
決定性は自ら付与するものです。 再現可能な処理はすべてコミット済みのスクリプトに寄せ、エージェントには判断を要する部分、すなわち決定、適応、説明を残します。コストを妥当な水準に保てるのもこの方針によります。
失敗はその場で記録してください。 ツールキットが高速化したのは、実行中にその場で解決すべき事項が継続的に減少したためです。長期的に効いてくるのは、文書化されたgotchasです。
範囲を絞り、深く掘る。 1領域を完全にマッピングし、完全に実行可能な状態にしたことで、1四半期でリグレッション1周を成立させ、次の領域に適用できる型も得られました。
本施策の適用範囲外
本施策は自動リグレッションテストと併存するものであり、担う役割が異なります。対象は、自動化コストが高い、変更頻度が高い、あるいは判断を要するE2Eケースです。担当者が自身の端末でログインしたテナントに対して実行されるため、ホスティング型のCIサービスではなく、本番環境には一切関与しません。結果を確認し、サインオフを行い、発見事項をバグとして扱うかを判断するのは、現在も人です。
システムレベルE2Eの1周実行コストを、担当者の半日相当から、1つのコマンドとレビューへと置き換える。開発の速度に追随するためにQAが必要としていたのは、まさにこれでした。
これからの方向性
同じ手法で隣接領域へマップを拡張し、期待値と実測値で記述されたテストケースを、宣言的な実行可能スペックへと変換していきます。これにより、テストケース自体がデータファイルになるため、変更点を差分で確認でき、同じ実行をそのまま再現できるようになります。あわせてトレーサビリティツールを改善してループを閉じ、変更ごとに実行するケースの集合を、実行方法と同等の精度で選択できる状態を目指します。
Sansan技術本部ではカジュアル面談を実施しています

Sansan技術本部では、中途の方向けにカジュアル面談を実施しています。
現役エンジニアと、Sansanでの働き方や仕事の魅力について気軽にお話しできます。
「実際に働く人の話を聞いてみたい」という方は、ぜひご参加ください。カジュアル面談に申し込む
