本記事は、有志によるPyCon JP盛り上げイベントの一環として執筆したテックブログです!残念ながら採択とはならなかったプロポーザルですが、Pythonのボトルネックを高速化する知見として公開します。
buildersbox.corp-sansan.com
こんにちは、技術本部 研究開発部 Architectグループの蔀です。経理AXサービス「Bill One」のAI機能の開発を担当しています。
2025年11月、Bill Oneは「AI自動照合」という機能をリリース*1しました。この機能は、これまで人手で行っていた請求書の内容と納品・検収データとの照合や、発注データとの総額・明細単位での照合を自動化するもので、業務の大幅な効率化を実現します。
本機能は複数のチームで開発しており、研究開発部は照合エンジンの実装を行いました。*2
照合エンジンの実装は、当初はPythonのみで行っていました。ただ、大量のレコードを照合するときに速度低下が起きる問題がありました。
本記事では、その問題を解決するために行ったプロファイリングとPyO3を用いたRustコードへの置き換えについて紹介します。
なお、本記事では照合ロジックそのものの詳細な仕様には触れず、あくまで「パフォーマンス課題に直面したときに、どのようにプロファイリングを行いボトルネックを特定し、どうRustバインディングで解決したか」という一般化できるアプローチにフォーカスして紹介します。
目次
1.発生していた問題とプロファイリングでの原因追究
AI自動照合機能では、請求書データと発注データとの間で、総額や明細単位の文字列や数値の突き合わせを行っています。この手の「大量のレコード同士を突き合わせる」処理は、業務システムではよく登場するパターンだと思います。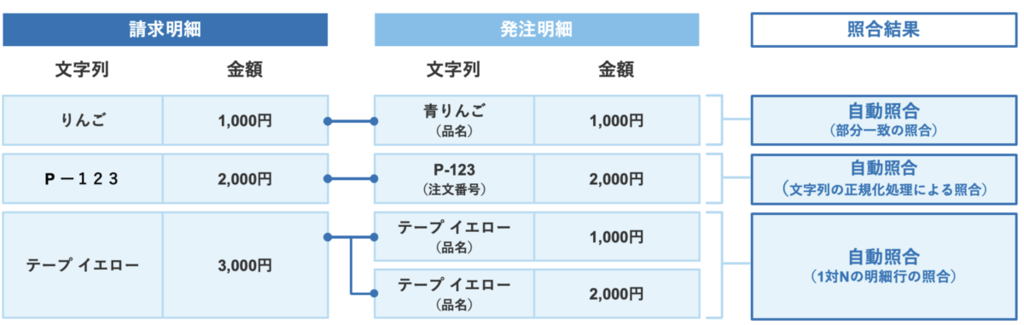
処理の構造を一部簡略化し一般化すると、次のようなシンプルな実装コードになります。以降、このコードを題材に説明を行います。
def match_records(source_records: list[dict], target_records: list[dict]) -> list[dict]:
    matched = []

    for source in source_records:
        for target in target_records:
            match_kind = None
            if source["key"] == target["key"]:
                if abs(source["amount"] - target["amount"]) <= 1:
                    match_kind = "perfect"
            elif source['key'] in target['key']:
                if abs(source["amount"] - target["amount"]) <= 1:
                    match_kind = "source_in_target"
            elif target['key'] in source['key']:
                if abs(source["amount"] - target["amount"]) <= 1:
                    match_kind = "target_in_source"
            if match_kind is not None:
                matched.append({
                    "source_id": source["id"],
                    "target_id": target["id"],
                    "diff": source["amount"] - target["amount"],
                    "kind": match_kind
                })
    return matched
sourceとtargetのレコードを総当たりで突き合わせ、条件に合うものを結果に追加する、というシンプルな実装です。件数が少ないうちは何の問題もなく動きます。しかし、レコード数が増加するに従い、処理時間が伸びます。
この関数だけを見れば、ボトルネックになり得る箇所は一目で分かります。しかし、実際のアプリケーションでは前後にさまざまな加工処理が存在するため、どの処理がレイテンシ増加の原因なのかをコードだけから特定することは容易ではありません。
プロファイリング
そこで、各関数にどの程度の実行時間が費やされているかを計測するプロファイラであるPyinstrumentを使用して、プロファイリングを行いました。以下のようにPyinstrumentをインストールし、プロファイリングを実行できます。uv add --dev pyinstrument # 開発時のみ必要なため開発依存として追加 uv run pyinstrument <計測したい対象のスクリプト>
上記の関数について、乱数を用いてsourceとtargetそれぞれ3万レコードを生成し、プロファイリングを実行した結果がこちらです。それぞれの関数とその関数内で実行されたものが木構造で出力されます。
これを見ると、全体で約121秒かかっており、その多くがmatch_records関数に費やされていることが分かります。
  _     ._   __/__   _ _  _  _ _/_   Recorded: XX:XX:XX  Samples:  115170
 /_//_/// /_\ / //_// / //_'/ //     Duration: 121.302   CPU time: 121.232
/   _/                      v5.1.3

Program: src/main.py

121.303 <module>  main.py:1
└─ 120.895 run_match_records_with_random_data  main.py:77
   └─ 120.467 match_records  main.py:7
      ├─ 112.856 [self]  main.py
      ├─ 5.530 abs  <built-in>
      └─ 2.082 list.append  <built-in>
2.なぜRustバインディングを選んだか
プロファイリングによって、大量のレコードを処理する際に時間を要している箇所を特定できました。これを踏まえ、最初に取ったアプローチはアルゴリズムの見直しでした。具体的には、キーや金額ごとの事前グルーピングなどによって、不要な比較演算を減らす改善を行いました。しかし、この改善だけでは求めていた処理速度には達しませんでした。アルゴリズムレベルの改善だけでは限界があり、最終的には、この比較処理をPythonのループで大量に実行することによるオーバーヘッドがボトルネックになっていました。
そこで、次の一手として言語レベルでの高速化を検討しました。ただし、処理全体を別言語に置き換えるのではなく、既存のPython実装を生かしながら、ボトルネックとなっている部分だけを高速化したいと考えました。そのため、Pythonから別言語の処理を呼び出すFFI(Foreign Function Interface)方式を検討しました。以降では、まずなぜFFIという方式を選んだか、その上でFFIの実装手段としてなぜRustバインディングを選んだか、という順に説明します。
なぜFFI方式を選定したか
改善の方針として、2点の要件を満たすものを選定する必要がありました。- 既存のPython資産をそのまま生かせること:APIとしての入出力やストレージからのデータロードといった処理は、すでにPythonで実装されており、十分に安定して稼働しています。処理全体を別言語に移行するのではなく、ボトルネックとなっている計算部分だけを切り出して高速化する必要がありました。
- 将来的な機械学習モデルの推論への拡張性があること:今後、照合処理の一部に機械学習モデルによる推論を組み込むことも見据えていました。将来的にPythonの機械学習エコシステムを利用して推論処理を追加する可能性があったため、アプリケーション全体はPythonのまま維持したいという要件がありました。
これらの要件を満たす手段として、Pythonをメインの実装言語としつつ、ボトルネックとなる部分だけをFFI経由で呼び出す形式が最適だと判断しました。処理全体を置き換えるのではなく、必要な部分だけを外部関数として切り出せるため、既存のPython資産を生かしながら将来的な拡張にも対応しやすい構成です。
なぜRustバインディングか
この高速化を実現する手段として、CythonやNumbaなどの選択肢もありましたが、今回はRustとPyO3を採用しました。理由はいくつかあります。Python公式ドキュメントでも、PythonのC拡張を作成するためのサードパーティツールの一つとしてPyO3が紹介されています。*3また、C APIを直接扱う場合と比べて、Rustの型システムを生かしながら拡張を実装できる点が採用理由の一つでした。
今回の照合処理はキーの文字列比較を多く含みますが、Rustは文字列処理まわりのライブラリが豊富で、この点でも今回の用途に適していました。加えて、社内ではすでにRustの採用実績があり、有識者も在籍していたため、実装や運用面での相談がしやすく、ノウハウをゼロから積み上げる必要がなかったことも大きな決め手になりました。
3.PyO3による実装
PythonからRustコードを呼び出すために、PythonパッケージとしてのRustバイナリファイルを作る必要があります。今回は、そのRustバイナリファイルを作るためにPyO3を用い、ビルドツールとしてmaturinを用いました。
実際のプロジェクトで行ったPyO3への置き換えを、サンプルコードでも再現してみます。
最初に置き換えるときは、PythonクラスをRustの構造体などに置き換え、Python版とできるだけ対応関係が分かりやすくなるように心がけました。これにより、単体テストコードなどもスムーズに置き換えることができました。
実装
ディレクトリ構造は以下のように想定します。Pythonプロジェクト内に、Rustパッケージディレクトリがある構造です。
<Pythonプロジェクト>
├── pyproject.toml
├── src
│   └── main.py        <- Rustパッケージを呼び出す側のPythonコード
└── <rust_package_name>
    ├── Cargo.toml
    ├── pyproject.toml
    └── src
        └── lib.rs     <- Rustでの実装
まず、maturinをインストールして、Rustのパッケージディレクトリを作ります。
uv tool install maturin
maturin new <rust_package_name>
maturin newを実行すると、Cargo.tomlやpyproject.toml、src/lib.rsのひな形が自動生成されます。ここに実際の突き合わせロジックを実装していきます。
以下が、1章で示したPython版match_recordsをRustに移植した実装です。
use pyo3::exceptions::PyValueError;
use pyo3::prelude::*;
use serde::{Deserialize, Serialize};


#[derive(Deserialize)]
struct Record {
    id: String,
    key: String,
    amount: i64,
}

#[derive(Clone, Copy, PartialEq, Serialize)]
#[serde(rename_all = "snake_case")]
enum MatchKind {
    Perfect,
    SourceInTarget,
    TargetInSource,
}

#[derive(Serialize)]
struct MatchResult<'a> {
    source_id: &'a str,
    target_id: &'a str,
    diff: i64,
    kind: MatchKind,
}

#[pyfunction]
fn match_records(py: Python<'_>, source_json: &str, target_json: &str) -> PyResult<String> {
    let source_records: Vec<Record> = serde_json::from_str(source_json)
        .map_err(|e| PyValueError::new_err(format!("failed to parse source json: {e}")))?;
    let target_records: Vec<Record> = serde_json::from_str(target_json)
        .map_err(|e| PyValueError::new_err(format!("failed to parse target json: {e}")))?;

    py.detach(|| {
        let mut matched = Vec::new();
        for source in &source_records {
            for target in &target_records {
                let mut match_kind = None;
                if source.key == target.key {
                    match_kind = Some(MatchKind::Perfect);
                } else if target.key.contains(&source.key) {
                    match_kind = Some(MatchKind::SourceInTarget);
                } else if source.key.contains(&target.key) {
                    match_kind = Some(MatchKind::TargetInSource);
                }

                let Some(kind) = match_kind else {
                    continue;
                };

                if (source.amount - target.amount).abs() <= 1 {
                    matched.push(MatchResult {
                        source_id: &source.id,
                        target_id: &target.id,
                        diff: source.amount - target.amount,
                        kind,
                    });
                }
            }
        }
        serde_json::to_string(&matched)
            .map_err(|e| PyValueError::new_err(format!("failed to serialize result: {e}")))
    })
}

/// A Python module implemented in Rust.
#[pymodule]
fn module_name(m: &Bound<'_, PyModule>) -> PyResult<()> {
    m.add_function(wrap_pyfunction!(match_records, m)?)?;
    Ok(())
}
このコードのポイントは大きく3つあります。
1つ目は、PythonとRust間でのデータの受け渡しは文字列で行う点です。
PyO3ではPythonのdictやlistを直接扱うこともできますが、それらのPythonオブジェクトをRust側のコードで操作している間はPythonインタプリタへのアクセスが必要です。そこで今回は、Python側で入力をJSON文字列に変換し、Rust側で所有権を持つデータ構造にデシリアライズする構成にしました。言語の境界を越えてやり取りするのは文字列のみです。デシリアライズ後にRust側でピュアな型で定義される変数は、Rustのメモリアロケータによって割り当て・解放が行われるため、メモリ管理はRust側だけで完結します。
この構成により、GIL(Global Interpreter Lock)を解放できるため他のPythonスレッドをブロックせずにすみます。また、将来Rust側で並列処理を実装する場合も、GILの影響を受ける心配がありません。
2つ目は、判定ロジックの分岐順序をPython実装とそろえている点です。if/else ifの順序を、1章のmatch_recordsとそのまま対応させることで、移植時の挙動の差異を防いでいます。単体テストの結果をそのままRust版でも再利用できたのは、この対応関係を意識して実装したことが大きいです。
3つ目は、Rust側で発生したエラーをPyErr(Pythonの例外)に変換して伝播させている点です。Rust側ではPanicが起きないよう実装し、発生し得るエラーはResult型で処理した上で、PyValueErrorなどの具体的なPython例外型に変換してPyResult
Rust側の実装ができたら、Python側から呼び出すラッパー関数を用意します。
import module_name
import json

def match_records_wrapper(source_records: list[dict], target_records: list[dict]) -> list[dict]:
    matched_json = module_name.match_records(
        json.dumps(source_records),
        json.dumps(target_records),
    )
    return json.loads(matched_json)
このラッパー関数を用意することで、呼び出し側のコード(APIハンドラやその他のビジネスロジック)は、内部の実装がPythonなのかRustなのかを意識する必要がなくなります。関数のシグネチャを維持したまま中身だけ差し替えられるため、既存の単体テストコードもほぼそのまま流用できました。
最後に、Rustパッケージをビルドしてインストールします。
uv pip install <rust_package_name>/
maturin newで生成されたpyproject.tomlではmaturinがビルドバックエンドとして設定されています。そのため、このコマンドを実行するとmaturinを通じてRustコードがコンパイルされ、Pythonパッケージとしてインストールされます。以降は、通常のPythonパッケージと同じようにimport rust_package_nameとして利用できます。
苦労した点
Python版とできるだけ同じクラス・関数単位で実装することを心がけましたが、移植に当たって主に次の2点に苦労しました。- 所有権とライフタイム:Pythonでは参照やオブジェクトの寿命を強く意識せずに実装できる場面が多い一方、Rustでは所有権やライフタイムを考慮して実装する必要があります。そのため、Pythonの実装をそのままRustに置き換えようとすると、コンパイルエラーになることがありました。
こうした場面では、生成AIに解決策を提示してもらいながら実装を進めることで対応しました。
- 文字列処理:Rustでは、文字列をバイト列として扱うのか、UTF-8の文字列として扱うのかを意識する必要がありました。Pythonでは文字列を文字単位で扱いやすい一方、RustのStringやstrはUTF-8で保持されており、整数インデックスを使った文字単位のアクセスはできません。また、UTF-8の文字境界でない位置を指定してスライスすることもできません。
そのため、日本語などのマルチバイト文字を扱う箇所では文字境界を意識して実装し、テストケースを充実させることで考慮漏れを減らしました。
プロファイリング
PyO3実装でのプロファイリングが以下です。JSON変換の時間が追加されていますが、その点を考慮しても処理速度が向上しています。
なお、上記の単純化したサンプルでは約8倍の高速化となっています。一方、実際のプロダクションコードではアルゴリズムの改善も組み合わせた結果、処理全体で約30〜44倍の速度向上を実現しました。
PyO3実装でのプロファイリングでは、Rust側で関数内から関数を呼び出してもプロファイリングの結果としてそれらの関数ごとの処理時間は見られないので注意が必要です。
  _     ._   __/__   _ _  _  _ _/_   Recorded: XX:XX:XX  Samples:  88
 /_//_/// /_\ / //_// / //_'/ //     Duration: 15.314    CPU time: 15.294
/   _/                      v5.1.3

Program: src/main_rs.py

15.314 <module>  main_rs.py:1
├─ 14.635 run_match_records_with_random_data  main_rs.py:38
│  └─ 14.551 match_records_wrapper  main_rs.py:24
│     ├─ 7.705 loads  json/__init__.py:304
│     │  └─ 7.705 JSONDecoder.decode  json/decoder.py:340
│     │     └─ 7.705 JSONDecoder.raw_decode  json/decoder.py:351
│     └─ 6.834 match_records  <built-in>
└─ 0.673 [self]  main_rs.py
4.まとめ
本記事では、Pyinstrumentを用いたプロファイリングによるボトルネックの特定、そしてPyO3の選定背景と実装について紹介しました。ボトルネック解決のアプローチとして、まず取り組むべきはアルゴリズムの見直しだと考えています。しかし、それでも解決しない場合の選択肢の一つとして、今回紹介したような言語レベルでの見直しがあります。
今回はPyO3を用いたRustバインディングを選定しましたが、最適な選択肢は技術的な制約だけでなく、組織構成やチーム内の技術スタックによっても変わってきます。導入に当たっては、こうした技術以外の側面も含めて慎重に検討する必要があると思います。
導入後の運用面についても触れておきます。現在は、運用できるメンバーを増やすため、Rustを書いたことがないメンバーにも機能追加を担当してもらっています。実装にかかる時間については、生成AIの支援もあり、Python実装時と比べて大きく増えているという実感はありません。Rustの学習コストが運用上のボトルネックになるのではないかという懸念もあるかと思いますが、実際には生成AIによる補助もあって、思ったほど大きな障壁にはなっていない、というのが現時点での所感です。
Sansan技術本部ではカジュアル面談を実施しています
Sansan技術本部では中途の方向けにカジュアル面談を実施しています。Sansan技術本部での働き方、仕事の魅力について、現役エンジニアの視点からお話しします。「実際に働く人の話を直接聞きたい」「どんな人が働いているのかを事前に知っておきたい」とお考えの方は、ぜひエントリーをご検討ください。
